Семь ИИ-самураев
Они защищают человечество от будущего, которое сами ему продают.

В знаменитом фильме Акиры Куросавы «Семь самураев» (1954) между крестьянами и самураями лежит огромная социальная пропасть. Крестьяне боятся самураев и не доверяют им. Самураи, принадлежащие к воинскому сословию, привыкли смотреть на крестьян свысока. Но обстоятельства вынуждают обе стороны преодолеть взаимную неприязнь.
Крестьянам нужна защита от разбойников. Самураям предлагают скромную плату — рис, которого едва хватает для пропитания. И всё же они соглашаются защитить деревню.
За их решением стоят не только необходимость и сострадание, но и представления о воинской чести, что в Японии средневековья принято связывать с бусидо (武士道) — «путь воина».
У Куросавы семь самураев защищают деревню от разбойников средневековой Японии.
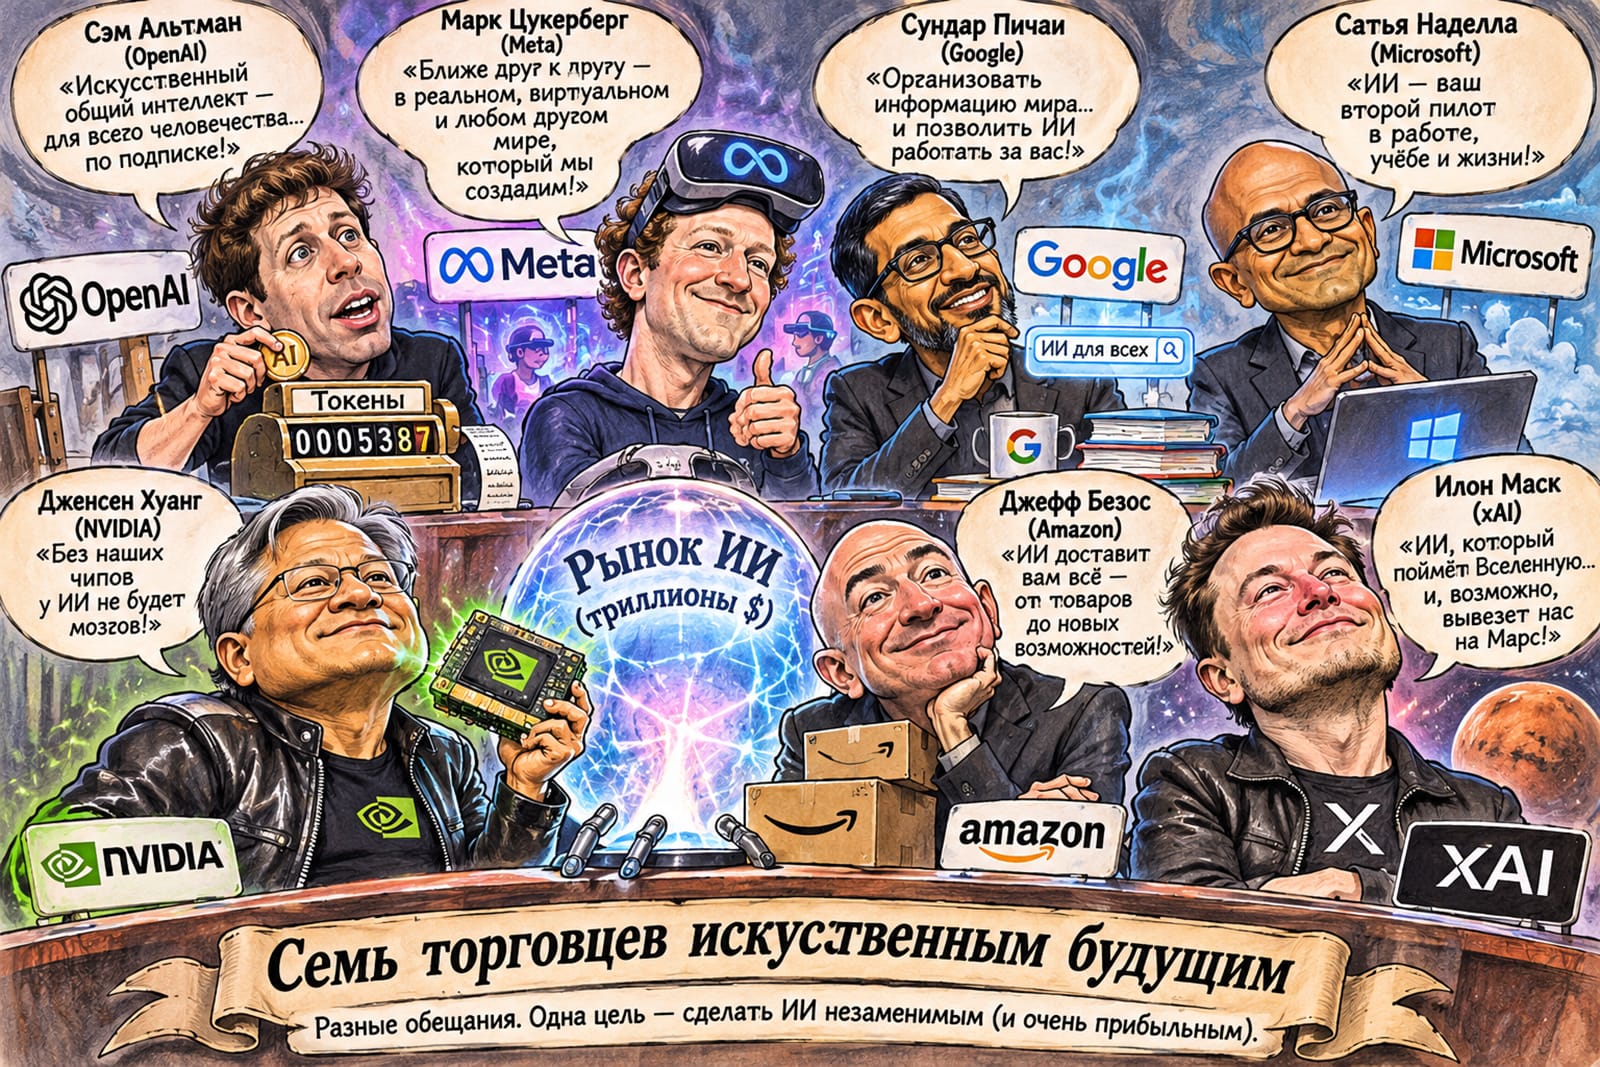
В нашей современной истории семь технологических магнатов (см, генерацию изображения агента Маруси/Open AI) обещают защитить человечество от агрессивности искусственного интеллекта, который они сами же разрабатывают.
Разница, правда, существенная. Самураи Куросавы не создавали разбойников. А наши ИИ-самураи одновременно разрабатывают технологию, предупреждают о её возможных угрозах, вплоть до исчезновения человечества, и предлагают свои услуги.
Поэтому нам, современным «крестьянам», было бы полезно выяснить, что представляет собой бусидо искусственного интеллекта. Каким кодексом чести руководствуются его создатели? И кого в действительности они собираются защищать?
Что ИИ-самураи продают нам, крестьянам?
Вы удивитесь, но это не рис. Нам продают токены. Не по зёрнышку, а горстями, мешками и целыми вагонами.
Токен — единица, на которую нейросетевая модель разбивает обрабатываемый текст. Это может быть целое слово, его часть, отдельный символ или даже знак препинания.
В отличие от человека, компьютер не понимает слова. Для понимания текста система сначала разбивает его на токены. Каждому токену соответствует числовой идентификатор — ID из словаря конкретного токенизатора. Затем эти идентификаторы преобразуются в числовые векторы, с которыми работает нейросеть. На основе контекста модель вычисляет вероятности возможных следующих токенов и последовательно формирует ответ.
Именно вероятности, а не гарантированно достоверные утверждения.
Поэтому под окном ChatGPT можно прочитать предупреждение: «ChatGPT может допускать ошибки. Проверяйте важную информацию». Это не просто юридическая предосторожность. Это важно, если вы в школе или университете не учили математику. Это напоминание о принципе работы технологии, которой мы все охотнее доверяем написание текстов, анализ документов, программирование и поиск ответов на сложные вопросы.
Но вернёмся к торговле.
Стоимость обработки токенов зависит от модели. В API различаются цены входных токенов — текста, поступающего в систему, — и выходных, из которых формируется ответ. Кроме того, один и тот же текст на разных языках может потребовать разного количества токенов.
Для примера возьмём GPT-6.1 Sol. По стандартным тарифам API OpenAI на ноябрь 2026 года:
1 000 входных токенов стоят $0,002.
1 000 выходных токенов — $0,01.
100 000 выходных токенов — $1.
Вы можете сами посмотреть сколько токенов будет стоить ваш вопрос и любые слова адресованные Open AI. Например, "In vino veritas" - 4 токена, а перевод с латыни на русский "Истина в вине" будет уже стоить 5 токенов. (Теперь понимаете почему французское вино в России стоит дороже?) На первый взгляд, токены стоят сущие копейки. Однако это продажные цены вычислительных услуг, а не фактическая себестоимость их производства.
Сколько компания тратит на создание каждого токена, нам точно неизвестно. ИИ-компании эту информацию скрывают. Мы можем оценивать затраты на вычисления, электроэнергию, амортизацию оборудования и разработку новых моделей, но полной внутренней калькуляции у нас нет. И здесь начинается самое интересное.
ИИ-самураи живут в долг
Токен может приносить компании операционную прибыль, а сама компания при этом оставаться глубоко убыточной. Причина — огромные расходы на разработку новых моделей, исследования, инфраструктуру, персонал и продвижение продуктов.
По опубликованным финансовым документам, выручка OpenAI в 2025 году составила около 13,1 миллиарда долларов, а операционный убыток — почти 20,9 миллиарда.
Иными словами, компания уже научилась продавать искусственный интеллект за огромные деньги, но пока не доказала, что постоянное создание всё более мощных моделей может стать устойчиво прибыльным бизнесом.
Важно, однако, не смешивать всех семерых. OpenAI и другие специализированные разработчики моделей существенно зависят от привлечения капитала, тогда как Google, Microsoft, Meta и Amazon могут финансировать инвестиции в ИИ за счёт других, уже прибыльных направлений своего бизнеса. NVIDIA, в свою очередь, зарабатывает прежде всего на продаже оборудования для вычислений.
И всё же вся индустрия ИИ нуждается в колоссальных инвестициях. И что же?
Инвесторам обещают революцию в мировой экономике. Пользователям — интеллектуальных помощников, которые станут незаменимыми. Обществу — будущее, в котором искусственный интеллект решит едва ли не все проблемы человечества.
Казалось бы парадоксально, но одновременно руководители компаний предупреждают о рисках технологии, которую предлагают нам приобрести.
Получается своеобразная торговля будущим: сначала нам объясняют, насколько оно неизбежно, затем — насколько опасно, а после предлагают оформить платную подписку.
Но что произойдёт, если инвесторы однажды перестанут финансировать стремительное развитие ИИ и потребуют не обещаний, а устойчивой прибыли?
Останется ли искусственный интеллект столь же доступным? Или сегодняшние сравнительно дешёвые услуги — лишь временный этап, пока стоимость технологической гонки оплачивается привлечённым капиталом?
Где взять электричество для цифрового будущего?
У этой истории есть ещё одна сторона, о которой значительно реже рассказывают в рекламных презентациях.
Искусственный интеллект требует не только денег, но и огромных вычислительных мощностей. А следовательно — электроэнергии. Это уже не исключительно финансовый риск, а вполне физическое ограничение.
Дело не в том, что человечеству в принципе не хватит электричества. Проблема в другом: необходимые мощности далеко не всегда доступны именно там и тогда, когда их требуют новые центры обработки данных.
Согласно прогнозу Международного энергетического агентства (МЭА), к 2030 году на дата-центры может приходиться около 3% мирового потребления электроэнергии.
На первый взгляд, не так уж много.
Но в США, например, картина уже существенно отличается. По расчётам Национальной лаборатории имени Лоуренса в Беркли, к 2030 году дата-центры могут потреблять от 9,5 до 15,3% всей электроэнергии страны.
Речь идёт обо всех дата-центрах, а не только о тех, которые обслуживают ИИ. Но именно стремительное развитие искусственного интеллекта становится одним из главных факторов увеличения нагрузки. МЭА также предупреждает, что ограничения электросетей способны задержать подключение примерно 20% запланированных к 2030 году мощностей дата-центров.
Компьютерные технологии совершенствуются быстрее, чем строятся электростанции, линии электропередачи и трансформаторные подстанции.
И здесь обнаруживается парадокс цифровой революции:
скорость развития искусственного интеллекта всё больше зависит от скорости строительства вполне материальных сооружений из бетона, стали и меди.
Экологический след невидимого интеллекта
Третье системное ограничение — экология. Искусственный интеллект часто представляют как почти нематериальную технологию. Алгоритмы, нейросети, данные, цифровые модели, виртуальные помощники.
Но за этой невидимой интеллектуальной машиной стоит огромная материальная индустрия: добыча полезных ископаемых. Полупроводниковые заводы. Электростанции. Системы водоснабжения и охлаждения. Строительство дата-центров. Производство и утилизация компьютерного оборудования.
Современные вычислительные центры не только потребляют электричество. В зависимости от используемых технологий они могут расходовать значительные объёмы воды, создавать постоянный шум и увеличивать нагрузку на местную инфраструктуру. Резервные генераторы способны загрязнять воздух, а производство полупроводников сопровождается использованием химических веществ и образованием промышленных отходов. При этом экологические издержки распределяются крайне неравномерно.
Пользователь в одной стране получает удобную услугу. Компания в другой стране продаёт подписку. Инвестор в третьей рассчитывает на будущую прибыль. А жители небольшого города, рядом с которым построили крупный дата-центр, могут столкнуться с шумом, дополнительной нагрузкой на электросети и конкуренцией за водные ресурсы.
Они могут не иметь ни одной акции OpenAI, Microsoft, NVIDIA или Google. Но последствия развития мировой индустрии искусственного интеллекта оказываются буквально за их окнами.
Прогнозируемый совокупный объём электронных отходов, связанных с генеративным ИИ в период за 2020–2030 в различных сценариях составляет - 1,2–5 млн тонн.
Кто оплачивает будущее?
И вот мы подошли к четвёртой проблеме — возможно, самой важной.
Кто получает экономическую выгоду от искусственного интеллекта, а кто несёт издержки его развития?
Вопрос не сводится к тому, сколько зарабатывает OpenAI или сколько электричества потребляют дата-центры. Он касается распределения ресурсов, прибыли, ответственности и права принимать решения.
Кому принадлежит инфраструктура будущей цифровой экономики? Кто решает, где строить дата-центры? Кто оплачивает расширение электросетей? Кто контролирует расходы воды? И имеют ли жители право влиять на эти решения?
Это не означает, что развитие искусственного интеллекта необходимо остановить. Я точно этого не сторонник. Но строительство новых вычислительных центров, экологические ограничения и распределение экономических выгод должны становиться предметом публичного обсуждения, в котором участвуют не только "семь самураев" и государственные чиновники, но и местные сообщества.
Именно здесь технологическая революция превращается в вопрос гражданских прав.
А где же бусидо?
Вернёмся к Куросаве. В его фильме самураи, несмотря на сословные предрассудки, в конечном счёте становятся защитниками людей, которые не располагают ни властью, ни богатством. Они рискуют жизнью ради тех, кто не может достойно заплатить им за защиту.
Наши семь ИИ-самураев действуют в совершенно другом мире. Они руководят корпорациями, распоряжаются огромными капиталами инвесторов и конкурируют за контроль над технологиями нашего будущего.
И никто не требует от них средневекенного самопожертвования.
Но если они действительно претендуют на роль защитников человечества, то хотелось бы понять, существует ли у них собственный кодекс ответственности. Не рекламный слоган о прекрасном будущем, а вполне конкретные обязательства перед людьми, которые будут жить с последствиями их решений.
Возможно, главный вопрос заключается даже не в том, сумеет ли искусственный интеллект однажды превзойти человеческий разум. А в том,
сумеют ли люди сохранить право самостоятельно определять своё будущее в мире, где всё больше возможностей и ресурсов сосредоточено в руках нескольких технологических корпораций.
В финале фильма Куросавы предводитель самураев Камбэй произносит горькую мысль: победителями вновь оказались крестьяне, а не самураи.
Интересно, кто окажется победителем в нашей истории? Пока самураи только выставляют счета. А крестьяне платят.
Олег Климов, Photographer's Diary. 2 ноябрь 2026
Данные на основе источников:
- Ars Technica — финансовые показатели OpenAI за 2025 год.Ars Technica
- OpenAI — тарифы на токены GPT-6.1 Sol.OpenAI API
- МЭА — прогноз энергопотребления дата-центров, 2026.IEA
- Berkeley Lab — прогноз потребления электроэнергии дата-центрами США.datacenters.lbl.gov
- МЭА — ограничения электросетей и возможные задержки подключения.IEA
Подпишитесь в Telegram
Подписывайтесь на мой Telegram-канал, чтобы получать анонсы свежих публикаций, эксклюзивные новости и инсайды.
Подписка в Telegram